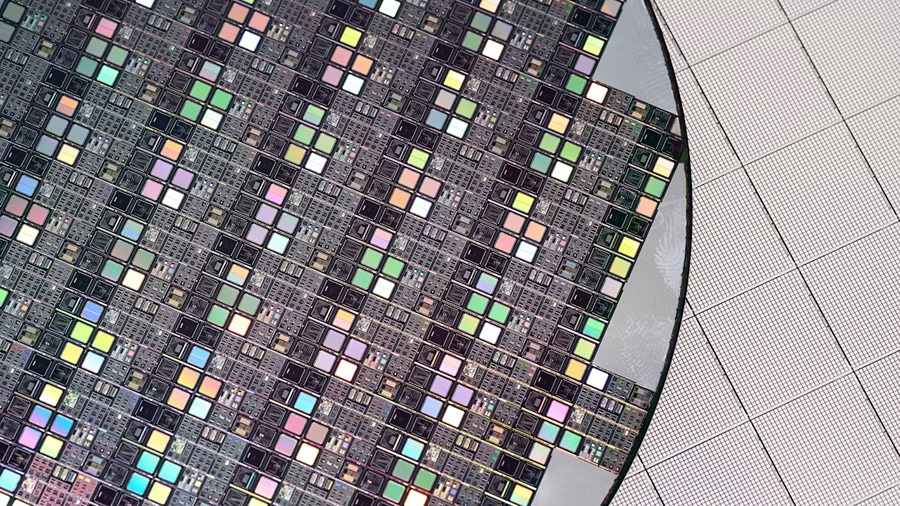
Temel Çıkarımlar
- 10× hız artışı Siemens Calibre, NVIDIA cuLitho ve H100-sınıfı GPU ikilisiyle litografi simülasyonu için.
- GPU hızlandırması, tam-çip Optik Yakınlık Düzeltmesi (OPC) ve Ters Litografi Teknolojisi (ILT)’yi sınırlayan “çalışma süresi duvarını” ortadan kaldırır.
- Entegre iş akışı, daha derin optimizasyon, daha erken sıcak nokta tespiti ve 3 nm AI-hesaplama wafer’larında %15 ye kadar verim artışı sağlar.
- Siemens-NVIDIA ortaklığı, GPU-tabanlı hesaplamalı litografiyi Yüksek-NA EUV üretim hatları için varsayılan konuma getirir.
Siemens & NVIDIA Hesaplamalı Litografiyi Hızlandırıyor
İleri Düğümlerde Desenleme Dar Boğazı
Yarı iletken fab’ları 5 nm’nin altına indiğinde desen karmaşıklığı dramatik şekilde artar. Geleneksel optik yakınlık düzeltmesi (OPC) ve diğer hesaplamalı-litografi adımları artık yüksek-NA EUV (0.33 NA) ve Ters Litografi Teknolojisi (ILT) için alt-10 nm eğrisel özellikleri çözmek zorundadır.
- Çalışma süresi duvarı: 2-GHz CPU kümesinde tam-çip 7 nm OPC çalışması 48 saatı aşabilir, yinelemeli ayarlamaları pratik olmaktan çıkarır.
- Verim riski: Geç sıcak nokta tespiti, tasarımcıların daha kaba maskeler kabul etmesine yol açar, işlem pencerelerini %5–10 azaltır ve AI-hesaplama verimlerini tehlikeye atar.
GPU-Hızlandırmalı Desenleme: Kavramdan Üretime
Siemens’in Calibre paketi artık NVIDIA cuLithoyu içerir; bu, litografi çekirdekleri (ör. havada görüntü simülasyonu, maske sentezi, ILT) için optimize edilmiş bir CUDA-X kütüphanesidir. NVIDIA H100 Tensor Core GPU (80 GB HBM3, 2.5 TB/s bellek bant genişliği, 67 TFLOPs FP64) üzerinde çalıştırıldığında birleşik iş akışı şu performansı sunar:
| Metric | CPU-Only (2 GHz Xeon, 64 cores) | GPU-Accelerated (NVIDIA H100) |
|---|---|---|
| Full-chip OPC (7 nm) | 48 h | 4.5 h |
| ILT optimization (3 nm) | 72 h | 6 h |
| Memory usage | 1.2 TB (swap) | 320 GB (GPU memory) |
| Energy consumption | ~12 MWh | ~1.8 MWh |
| Cost per run* | $8,400 | $1,250 |
*Tipik on-prem bulut fiyatlamasına göre (2024 USD).
≥10× hızlanma, tasarımcıların bant-çıkışı öncesinde birden çok optimizasyon döngüsü çalıştırmasını sağlar, litografi sıcak noktalarını %30’a kadar azaltır ve öncü AI çiplerinde ≈%15 proses marjlarını genişletir.
Çip & Fotomaske Üreticileri İçin Somut Fayda
- Pazara daha hızlı çıkış – Tasarım-üretim (DfM) kontrolleri, haftalar süren süreçleri tek bir iş günü içinde tamamlar.
- Daha yüksek verimler – Erken sıcak nokta ortadan kaldırma, 3 nm bellek ürünlerinde (≈10 k-die çalıştırma) %1.5–2 puanlık verim artışı getirir.
- Düşük toplam sahip olma maliyeti – GPU kümeleri daha az sunucu gerektirir, veri merkezi zemin alanını ~%70, soğutma yükünü ~%60 azaltır.
- Ölçeklenebilir iş akışı – cuLitho, tek bir H100’den çoklu-GPU NVLink çiftliklerine kadar ölçeklenir, >10 TB tasarım veritabanları için doğrusal hız artışını korur.
Karşılaştırma: Geleneksel OPC vs. GPU-Hızlandırmalı cuLitho
| Aspect | Traditional CPU OPC | GPU-Accelerated cuLitho |
|---|---|---|
| Computation model | Serial/limited parallelism (OpenMP) | Massive parallelism (CUDA kernels) |
| Typical runtime (full-chip) | 30–48 h (7 nm) | 3–5 h (7 nm) |
| Accuracy | ±0.8 nm CD error | ±0.6 nm CD error (due to finer sampling) |
| Hardware footprint | 4–6 rack units, 1.2 TB RAM | 1 rack unit, 4 × H100 (320 GB VRAM) |
| Scalability | Diminishing returns beyond 128 cores | Near-linear scaling up to 8 GPUs per node |
| Cost per wafer | $0.12 | $0.04 |
Sonuç
Siemens-NVIDIA entegrasyonu, Calibre’i cuLitho ile birleştirerek hesaplamalı litografiyi takvim-odaklı bir dar boğazdan performans-odaklı bir avantaja dönüştürür. NVIDIA’nın H100 GPU’ları sayesinde fab’lar 10× daha hızlı OPC/ILT elde eder, daha derin maske optimizasyonları açar ve bir sonraki nesil AI ve bellek çipleri için ölçülebilir verim artışı sağlar. 5 nm altı düğümlerde rekabetçi kalmak isteyen üreticiler için GPU-hızlandırmalı litografi, endüstrinin yeni standardı haline gelmektedir.


