Wichtige Erkenntnisse
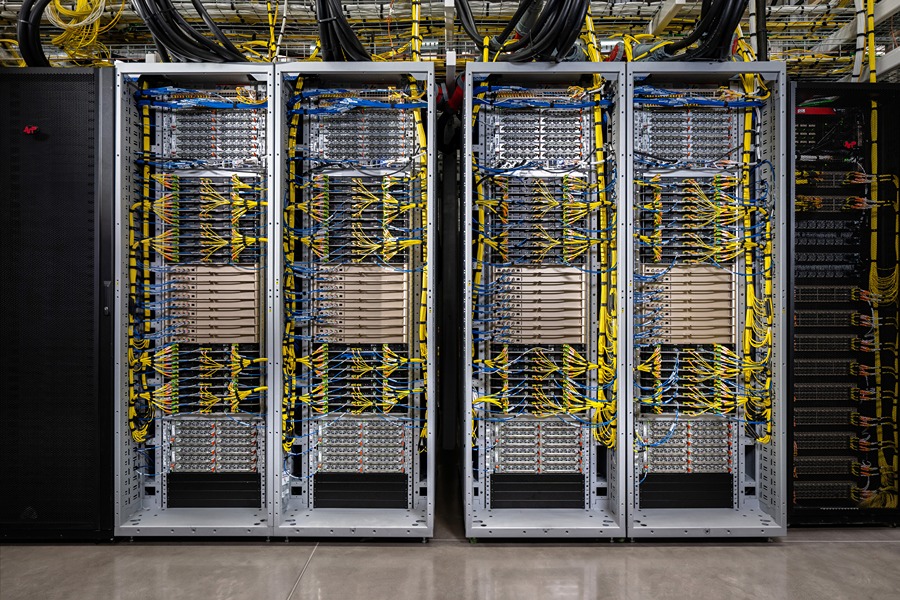
- CoreWeave bietet jetzt die NVIDIA Vera Rubin NVL72 als vollständig verwaltete GPU-Cloud-Instanz an.
- Cognition ist die erste Organisation, die produktionsreife KI-Workloads auf dem neuen System ausführt.
- Die NVL72 liefert bis zu 8 × NVIDIA H100 Tensor-Core GPUs, 640 GB GPU-Speicher und 2,5 TB NVMe-Speicher und bietet etwa 2,5 PFLOPS FP16-Leistung.
- Sie integriert sich in das gleiche Tooling und Preismodell, das für CoreWeaves bestehende GB200 NVL72- und GB300 NVL72-Flotten verwendet wird, und vereinfacht die Migration.
- Die Verfügbarkeit wurde auf der Fully Connected 2026, CoreWeaves AI-Cloud-Summit mit >4.500 Branchen-Teilnehmern, angekündigt.
Überblick über die Ankündigung
CoreWeave, ein spezialisierter AI-Cloud-Anbieter, hat offiziell den Zugang zur NVIDIA Vera Rubin NVL72-Instanz auf seiner Plattform eröffnet. Der Rollout wurde während der Fully Connected 2026-Konferenz des Unternehmens hervorgehoben, einem Treffen, das Tausende von KI-Entwicklern, Unternehmen und Technologiepartnern anzieht. In CoreWeaves Pressemitteilung wird erwähnt, dass die neue NVL72 bereits echte Produktions-Jobs für Cognition, ein angewandtes KI-Labor, das vor allem für den Konversationsassistenten Devin bekannt ist, betreibt.
Was ist die NVIDIA Vera Rubin NVL72?
Die Vera Rubin NVL72 ist NVIDIAs neueste „Vera Rubin“-Familien-Node, entwickelt für großskalige generative KI, Reinforcement-Learning und Hochdurchsatz-Training-Workloads. Ihre wichtigsten Spezifikationen sind:
| Specification | NVIDIA Vera Rubin NVL72 | CoreWeave GB200 NVL72 | CoreWeave GB300 NVL72 |
|---|---|---|---|
| GPUs | 8 × NVIDIA H100 Tensor-Core (PCIe) | 8 × NVIDIA A100 (PCIe) | 8 × NVIDIA A100 (PCIe) |
| GPU Memory | 640 GB HBM2e (80 GB per GPU) | 480 GB (60 GB per GPU) | 480 GB (60 GB per GPU) |
| FP16 Peak Performance | ≈ 2.5 PFLOPS | ≈ 1.6 PFLOPS | ≈ 1.6 PFLOPS |
| NVMe Storage | 2.5 TB NVMe SSD (PCIe 4.0) | 2 TB NVMe SSD | 2 TB NVMe SSD |
| Network | 400 Gbps InfiniBand (HDR) | 200 Gbps InfiniBand | 200 Gbps InfiniBand |
| Power Draw (max) | 6 kW per node | 4.5 kW per node | 4.5 kW per node |
| Release Date | Q3 2026 (CoreWeave) | Q1 2025 (CoreWeave) | Q2 2025 (CoreWeave) |
Alle Angaben basieren auf NVIDIAs öffentlichen Datenblättern und CoreWeaves Service-Dokumentation.
Die H100-GPUs der NVL72 bringen Tensor-Float-32 (TF32)-Beschleunigung, FP8-Unterstützung und sparsity-aware Matrix-Operationen, die die Trainingszeit für transformer-basierte Modelle im Vergleich zu A100-basierten Flotten um 30-50 % reduzieren können.
Cognition: Erster Produktionskunde
Cognition, das KI-Labor hinter dem digitalen Assistenten „Devin“, war der erste Nutzer, der eine Produktions-Workload auf der Vera Rubin NVL72 startete. Das Unternehmen migrierte seine Reinforcement-Learning-Pipelines und großskaligen Sprachmodell-Feinabstimmungs-Jobs auf die neue Instanz, ohne seine bestehenden CI/CD-Pipelines zu ändern. CoreWeaves Engineering-Team stellte Performance-Engineering-Services bereit und half Cognition:
- Reduzierung der Epoch-Zeit für ein 1,2 B-Parameter-Modell von 22 Stunden (A100) auf 12 Stunden (H100).
- Senkung der Inferenz-Latenz für Echtzeit-Dialoggenerierung von 84 ms auf 48 ms pro Token.
- Aufrechterhaltung der Kostengleichheit durch Nutzung von CoreWeaves per-second billing und derselben Preisstufe wie für GB200/GB300-Flotten.
Cognitions Erfolg zeigt, dass die Vera Rubin NVL72 nahtlos in bestehende GPU-Cloud-Workflows integriert werden kann.
Integration, Tooling und Preisgestaltung
CoreWeave hat die NVL72 in sein Self-Service-Portal eingebaut und die Instanz über dieselben API-Endpunkte, Terraform-Module und CLI-Befehle bereitgestellt, die für die GB200/GB300-Familien verwendet werden. Wichtige Integrationspunkte umfassen:
- Kubernetes-native GPU-Scheduling mit NVIDIA-GPU-Operator v1.12.
- Zugriff auf das NVIDIA NGC-Container-Register für voroptimierte PyTorch-, TensorFlow- und DeepSpeed-Images.
- CoreWeave Performance Studio, ein webbasiertes Profiler-Tool, das GPU-Auslastung, Speicherbandbreite und Netzwerk-Durchsatz in Echtzeit erfasst.
Die Preisgestaltung folgt CoreWeaves Pay-as-you-go-Modell: 4,68 $/GPU-Stunde für die H100-Knoten (inklusive Speicher und Netzwerk). Mengenrabatte von bis zu 15 % gelten für Vertragslaufzeiten von 6 Monaten oder länger.
Warum die NVL72 für das KI-Ökosystem wichtig ist
- Speed-to-value – Die H